눈에 보이는 글자가 항상 텍스트는 아닙니다
PDF에 분명히 단어가 있는데 찾기 기능으로 검색하면 결과가 없을 때가 있습니다. 화면에 보이는 글자가 문자 데이터가 아니라 그림의 일부일 수 있기 때문입니다. 종이를 스캔하거나 문서 화면을 이미지로 저장한 뒤 PDF에 넣은 경우가 대표적입니다.
먼저 짧은 단어를 검색하고, 그 부분을 복사해 보세요. 처음부터 문서 전체를 변환하기보다 검색 범위의 문제인지, 문자 데이터가 없는지 구분하는 편이 빠릅니다.
다만 검색이 안 된다는 사실 하나로 이미지 PDF라고 단정할 수는 없습니다. 글자가 잘못 인식됐거나 복사 제한이 있는 경우도 있습니다. 아래의 예제와 확인 순서를 함께 사용하세요.
같은 내용의 PDF2개를 만들었습니다
비교용 문서는 가상의 공책 주문서입니다. 실제 이름이나 거래 내역은 없습니다. 하나는 문자를 직접 넣었고, 다른 하나는 첫 PDF의 페이지를 그림으로 만든 뒤 그 그림만 새 PDF에 넣었습니다.
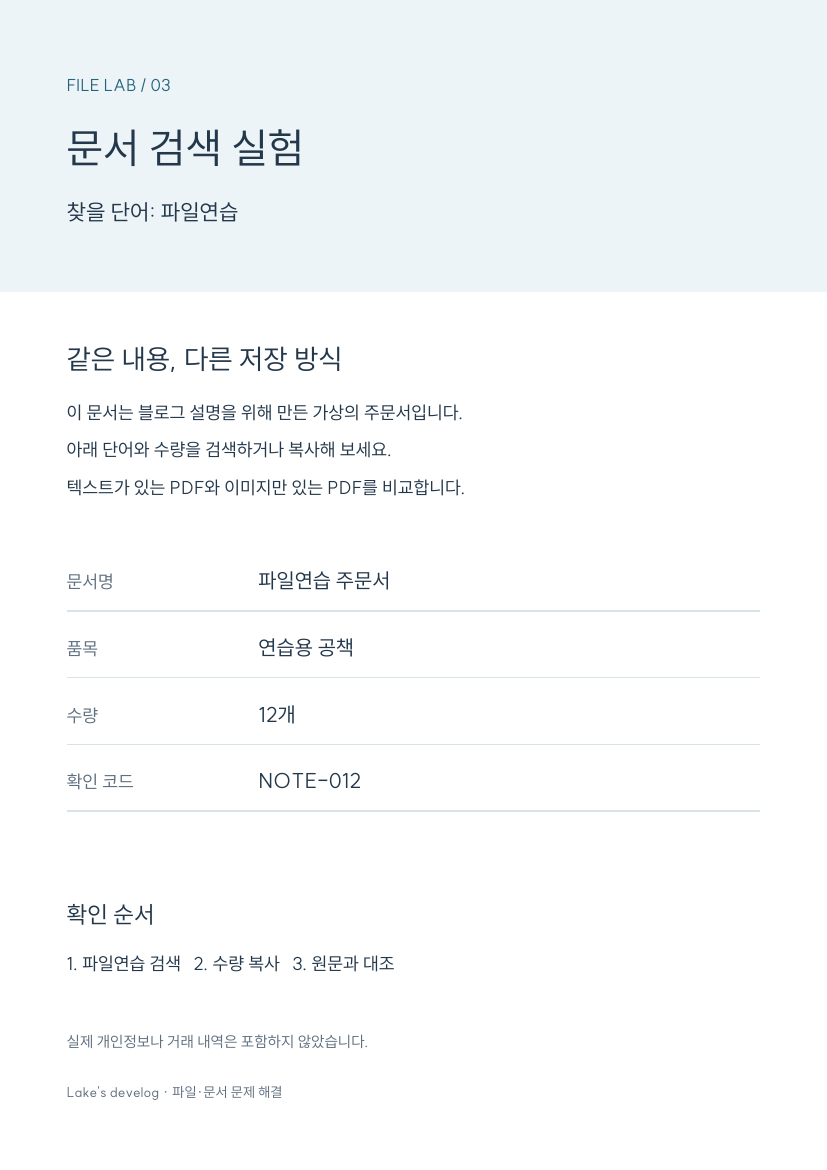
두 파일을 각각 열고 PDF 뷰어의 찾기 기능에서 파일연습을 검색해 보세요. 이어서 12개를 선택해 메모장에 붙여넣어 보세요. 브라우저를 사용한다면 주소창이나 웹페이지 검색이 아니라 PDF 안의 찾기 기능을 사용해야 합니다.
| 확인 항목 | 문자 데이터가 있는 PDF | 이미지만 있는 PDF |
|---|---|---|
| 화면에 주문서가 보이는가 | 보임 | 보임 |
| 페이지 수 | 1페이지 | 1페이지 |
| 파일 크기 | 18,846바이트 | 85,974바이트 |
| 문자 추출 도구가 ‘파일연습’을 읽는가 | 읽음 | 읽지 못함 |
표의 결과는 자동 문자 인식 기능이 없는 pypdf로 확인했습니다. 문자 PDF에서는 단어가 추출됐고, 이미지 PDF에서는 추출된 문자가 없었습니다. 일부 뷰어는 이미지를 자동으로 읽어 검색이나 복사를 지원할 수 있습니다. 그런 뷰어에서 두 번째 파일도 검색된다고 해서 원래 파일에 문자 데이터가 있었다는 뜻은 아닙니다.
검색이 안 될 때 확인할 순서
1. 검색 범위와 검색어를 줄이세요
현재 PDF의 찾기 기능인지 먼저 확인하세요. 문장 전체 대신 눈에 보이는 단어1개를 입력하세요. 띄어쓰기나 줄바꿈이 섞인 긴 문장은 다른 형태로 저장돼 있을 수 있습니다. 짧은 단어는 검색되는데 긴 문장만 검색되지 않는다면 이 차이부터 살펴보세요.
2. 단어를 복사해서 내용을 확인하세요
글자를 선택할 수 있다면 메모장 같은 일반 텍스트 편집기에 붙여넣으세요. 화면의 글자와 붙여넣은 글자가 같은지 비교하세요. 엉뚱한 문자나 순서가 나온다면 원본의 문자 저장 방식 또는 기존 문자 인식 결과에 문제가 있을 수 있습니다.
선택이 되지 않더라도 바로 이미지 PDF로 결론 내리지 마세요. 뷰어의 선택 도구를 확인하고, 문서 속성에 복사 제한이 있는지도 살펴보세요. 제한이 있다면 문서 제공자에게 복사 가능한 파일을 요청하세요.
3. 편집 가능한 원본이 있으면 다시 내보내세요
워드프로세서나 문서 편집기의 원본이 남아 있다면, 화면을 캡처해 PDF로 만드는 대신 해당 앱의 PDF 내보내기를 사용하세요. 내보낸 뒤 단어 검색과 복사를 다시 확인하세요. PDF라는 확장자만으로 검색 가능 여부가 보장되지는 않습니다.
원본이 없고 페이지가 그림뿐이라면 문자 인식이 필요합니다. OCR은 그림 속 글자를 읽어 문자 데이터로 바꾸는 기능입니다. 이미지 위에 검색 가능한 문자를 추가하는 방식도 있습니다. PDF의 구조와 문자 추출의 한계는 pypdf의 설명에서 더 확인할 수 있습니다.
이미지 PDF에는 문자 인식을 적용하세요
Acrobat에서는 모든 도구 → 스캔 및 OCR → 텍스트 인식에서 처리할 페이지와 언어를 정하는 흐름을 제공합니다. 설치 버전과 사용 권한에 따라 메뉴와 이용 가능 여부는 달라질 수 있습니다. 이 경로는 Adobe 공식 안내를 기준으로 정리했습니다. 이 글의 예제를 Acrobat에서 처리한 결과는 아닙니다.
문자 인식을 지원하는 도구를 쓸 때는 다음 순서로 확인하세요.
- 원본 PDF를 남기고 복사본으로 시작하세요.
- 문서에 맞는 인식 언어와 페이지 범위를 선택하세요.
- 처리 후 다른 이름으로 저장하고 다시 여세요.
- 필요한 단어를 검색하고 문장 일부를 복사하세요.
- 수량, 날짜, 코드처럼 틀리면 곤란한 값은 원본과 대조하세요.
검색 결과가 나온다는 것과 내용이 정확하다는 것은 다릅니다. 예를 들어 NOTE-012에서 숫자0과 영문 O가 바뀌면 코드를 그대로 찾지 못할 수 있습니다. 표에서는 글자는 맞아도 복사 순서가 달라질 수 있습니다. 실제로 사용할 부분을 확인한 뒤 작업을 마치세요.
검색되지 않는 파일을 받았을 때의 판단 기준
짧은 단어는 검색된다면 검색어와 줄바꿈을 먼저 확인하세요. 복사 결과가 깨진다면 편집 원본에서 다시 내보낼 수 있는지 확인하세요. 이미지뿐이고 원본도 없다면 문자 인식을 검토하세요. 복사 권한이 제한된 문서는 제공자에게 사용 가능한 형태를 요청하세요.
새 파일을 받거나 변환한 뒤에는 단어 검색 → 일부 복사 → 원문 대조를 반복하면 됩니다. 파일 이름이 바뀌었거나 ‘검색 가능’이라는 안내가 표시됐다는 이유만으로 확인을 끝내지 마세요.
예제 제작과 검증 범위
2026년10월4일에 ReportLab 5.0.1로 한글 텍스트 PDF를 만들었습니다. 같은 페이지를 144dpi 이미지로 렌더링한 뒤 이미지 PDF를 따로 만들었습니다. dpi는 1인치 길이를 몇 개의 점으로 표현하는지 나타내는 값입니다. 두 파일은 A4 크기의 1페이지 문서입니다.
pypdf 6.19.0으로 텍스트를 추출했고, 두 PDF를 각각 이미지로 렌더링해 글자 누락과 잘림도 확인했습니다. 문서 안에 자동 실행 동작이나 첨부 파일은 넣지 않았습니다. 이번 비교에서는 OCR을 실행하지 않았으며, 특정 서비스의 문자 인식 정확도를 측정하지 않았습니다.
PDF별 측정값과 저장소의 scripts/generate_blog_pdf_examples.py에서 예제 생성 조건을 확인할 수 있습니다.
함께 읽어보세요
운영 중인 블로그 글을 PDF로 저장하니 마지막인5쪽에 안내가 조금 남았습니다. 빈 쪽으로 오해하기 쉬운 부분과 표·그림·링크를 확인하는 방법을 정리합니다.
같은 텍스트 파일을 여는 링크4가지를 Chromium에서 비교했습니다. PC와 Android Chrome에서 파일을 저장하는 순서와 웹페이지를 잘못 저장했을 때 확인할 점을 정리합니다.
실제 파일3개를 만들고 바이트 수와 브라우저가 읽은 크기를 비교했습니다. 반올림 표시와 용량 단위를 구분하고 업로드 제한을 확인하는 방법을 안내합니다.
실제 파일을 만들어 로컬 파일 공유 화면의 순서를 확인했습니다. 번호와 날짜 자릿수를 맞추기 전후의 화면, 예제 ZIP, 다시 확인할 방법을 제공합니다.